财闻APP

百度加快布局推理芯片,昆仑芯M300与天池1024卡超节点计划明年上市
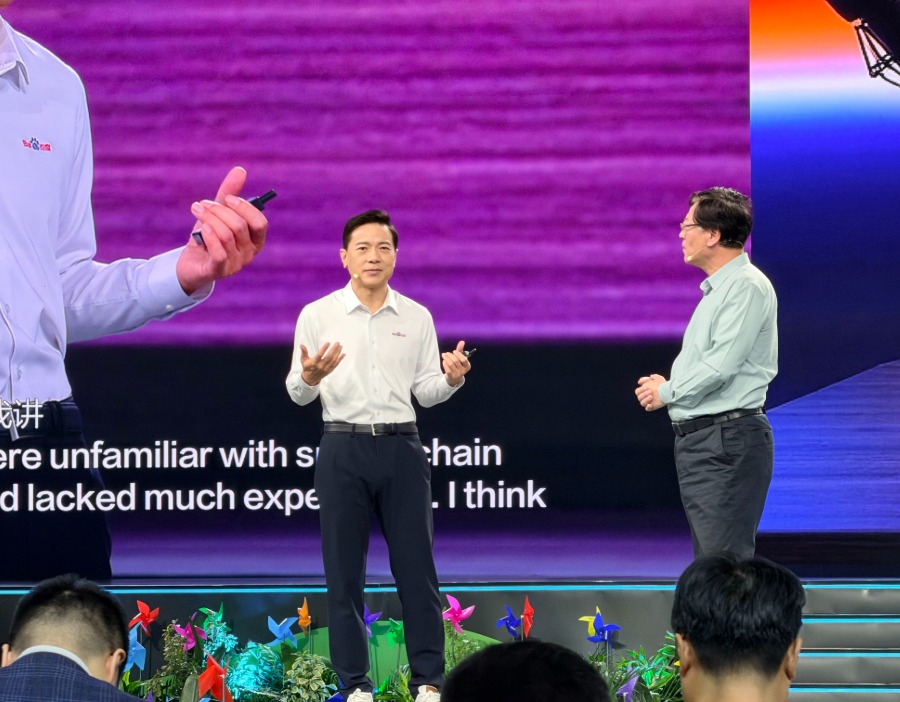
李彦宏在11月12日的百度世界2026开幕式上表示,训练和推理需求已并重,智能体规模化将带动推理需求增长,推理会成为AI芯片长期增长的重要推动力。
随着智能体开始处理更多任务,模型需要频繁响应用户指令,日常推理的AI算力需求日益旺盛。
百度(BIDU.US)创始人李彦宏在11月12日的百度世界2026开幕式上表示,训练和推理需求已并重,智能体规模化将带动推理需求增长,推理会成为AI芯片长期增长的重要推动力。

百度此次公布的芯片和算力产品计划,主要围绕这一变化展开。
昆仑芯M100已如期上市,M300计划于2027年推出,基于全新N架构的多款芯片计划于2028年推出。百度称,M100主打性价比,M300则将在算力、存储和互联方面升级,以适配不同模型和应用场景。
千卡超节点上市时间提前一年
百度集团执行副总裁沈抖在会上发布天池1024卡超节点,计划于2027年推向市场。超节点把多张AI芯片连接起来,使它们能够协同工作,承担大模型训练和推理任务。
百度此前公布过天池256卡和512卡超节点,并计划2028年推出千卡级超节点。这次发布的1024卡产品,将千卡级超节点的上市时间提前了一年。
百度称,天池1024卡超节点采用光引擎技术,卡间互联带宽较上一代提升3倍,训练性能提升2.5倍,推理性能提升3倍。单套系统可支持5万亿参数模型训练,并可扩展至万卡规模;采用新一代HPN架构后,百度称最大可搭建50万卡集群。

百度还介绍了两种加速柜。G1.5显存加速柜用于提升长上下文推理性能,百度称提升幅度为2倍;G3.5 KV Cache加速柜用于复用多轮对话中重复出现的内容。
百度称,在缓存命中的场景下,首Token等待时间可降低90%,吞吐提升7倍。
新模型与昆仑芯协同优化
会上,百度正式发布两款文心应用模型,分别是面向搜索、推理和工具调用的文心闪电深度思考模型,以及面向视频创作、强化人物表情和情绪表现的文心一镜微表情大模型。
两款模型同步上线百度智能云千帆平台,向企业客户及合作伙伴开放API。11月11日,百度还发布文心5.5 Flash Preview。
推理任务不仅需要芯片提供计算能力,也需要芯片、存储和软件配合,减少数据传输和重复计算。
百度称,文心一镜的极速版本可实现一分钟视频一分钟生成,生成成本较业内降低50%。
文心闪电则强调与昆仑芯的协同。百度介绍,该模型采用BSA稀疏注意力技术,可在昆仑芯上实现单机8卡推理。百度称,模型与昆仑芯协同优化后,推理引擎调用成本降低30%以上,模型ROI较同类芯片提升50%。目前公开通稿没有进一步说明ROI的计算方式、对比芯片和测试条件,相关数字仍需按百度口径呈现。

昆仑芯负责人在演讲中提到,Prefill和Decode等推理环节对芯片的需求并不相同,存储容量、数据移动速度和复用效率也会影响推理表现。