财闻APP

具身智能“下半场”:缺数据、卷数据、存争议
现有具身模型较为依赖数据,一旦训练数据没有覆盖现实中的场景、光照或物品变化,机器人就容易出错,往往需要重新采集数据。
具身智能行业仍在寻找可供模型训练的数据。
9月18日,在第九届中国机器人峰会上,多位企业和研究机构代表将数据视为具身智能发展的关键环节。
青瞳视觉创始人兼CEO张海威认为,具身智能的“数据荒”包含两层含义。一方面,人类社会过去没有为具身智能或物理AI准备训练数据,已有数据存量较少;另一方面,行业尚未完全明确什么是好数据,以及应该采集什么数据。
与语言模型主要处理文本不同,机器人需要在物理世界中行动。除了图像和视频,模型还需要理解人体或机器人的动作、物体之间的空间关系,以及动作发生后环境产生的变化。
浙江大学教授、浙江人形机器人创新中心首席科学家熊蓉在会上表示,现有具身模型较为依赖数据。一旦训练数据没有覆盖现实中的场景、光照或物品变化,机器人就容易出错,往往需要重新采集数据。
她还提到,真实环境中的数据采集效率较低,机器人在探索过程中也容易发生真机故障。仿真可以生成更多数据,但仿真与真实世界之间仍有差距。视觉也无法完整反映物体重量、表面光滑度以及接触时的受力情况,因此还需要加入力和触觉信息。
围绕这些问题,企业设计出不同的数据采集系统。
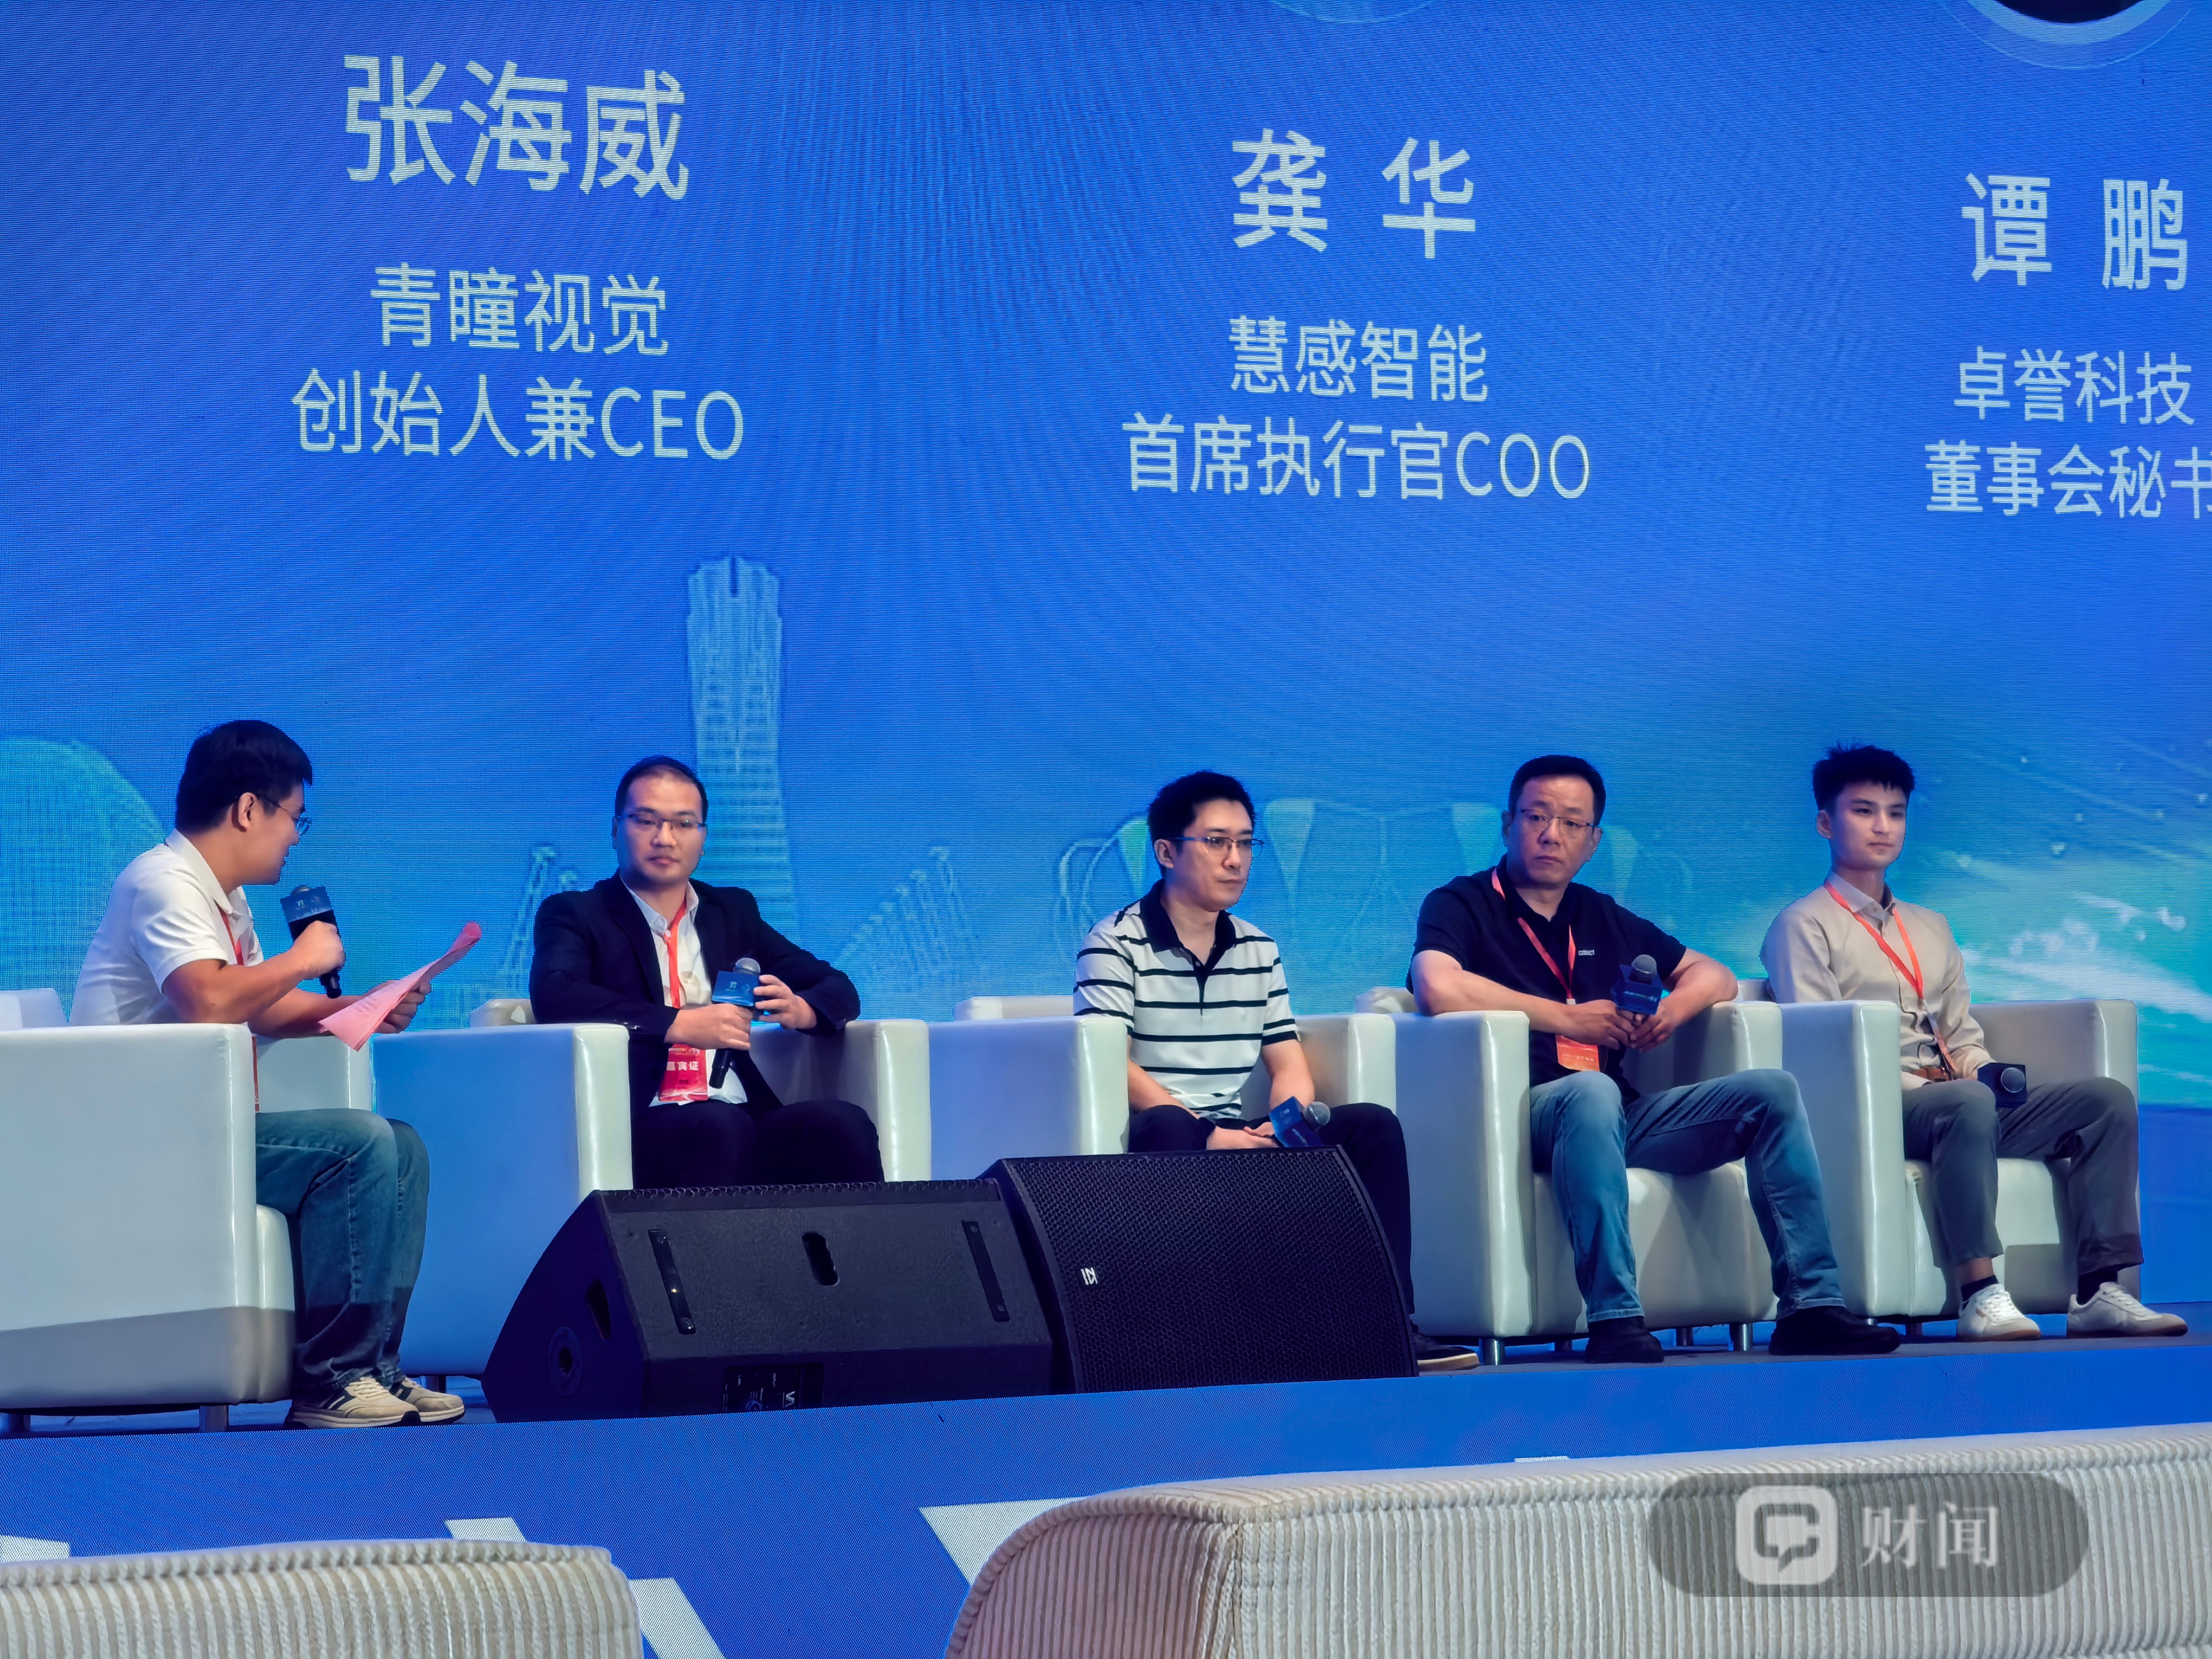
张海威介绍,青瞳视觉正在把全身动作捕捉、视觉定位、深度相机和SLAM等能力组合成数据采集方案。公司既采集身体运动数据,也在向“身体运动加操作”延伸。其数据采集系统可以与数据手套等设备组合使用。
据张海威现场披露,宇树科技、智元机器人、银河通用、上海人形和北京人形等机构正在使用公司的动作捕捉产品。青瞳视觉近期也在为十多家企业定制数据采集基础方案。
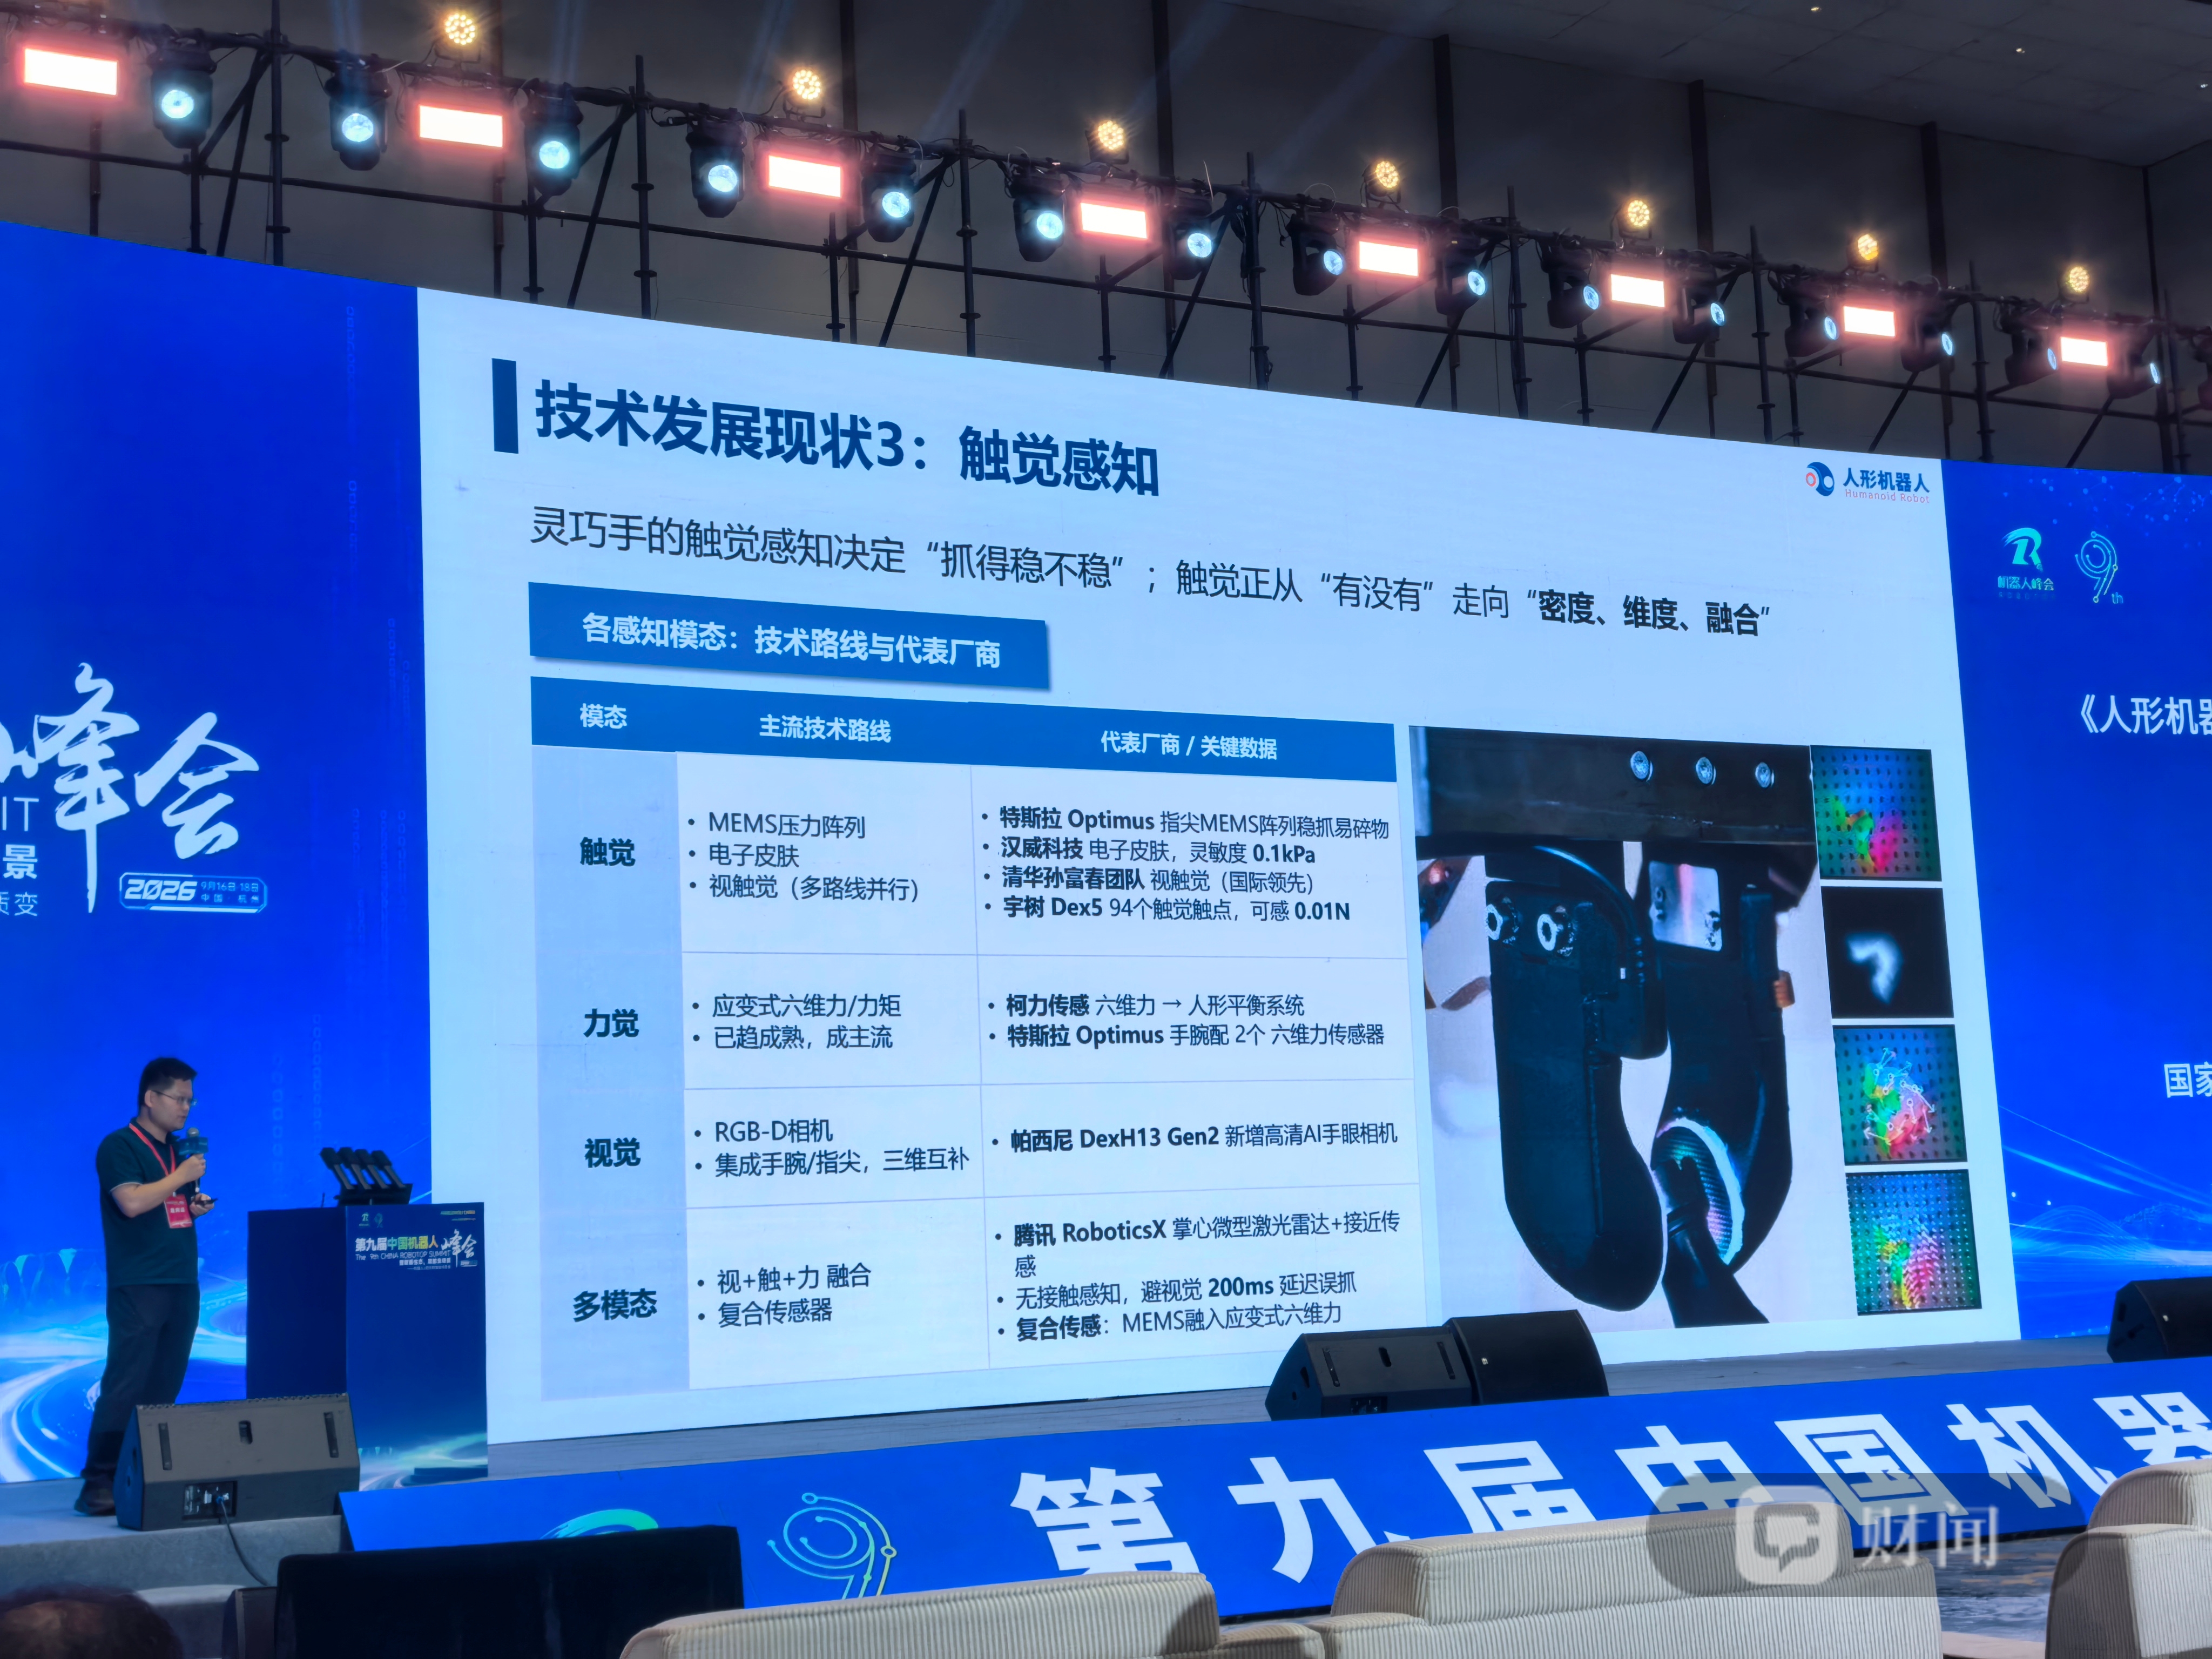
国家地方共建人形机器人创新中心则在增加手部姿态和触觉数据。该中心组件研发部主任李泳耀介绍,团队开发的第一人称数据采集系统由头戴设备和数据手套组成,目前已经迭代两版,研发团队接近30人。
其中,数据手套包含23个惯性测量单元,用于记录人体手部关节数据;手套上还有一两百个触觉点,可以记录人抓取物体时的接触信息。据李泳耀介绍,该系统能够实现亚毫秒级多模态对齐,手部姿态解算精度不超过3度,并已完成仿真环境和机器人真机的数据回放验证。
该中心还建设了VTouch视触觉多模态数据集。李泳耀称,数据集总规模为1000小时,目前已经开源100小时,下载量达到100万次。
真人第一视角数据也是上述数据路线之一。它通常由人佩戴相机或其他传感器,在真实环境中完成做饭、整理物品和操作工具等任务。这些数据记录了人看到了什么、执行了什么动作,以及环境随后发生了什么变化。
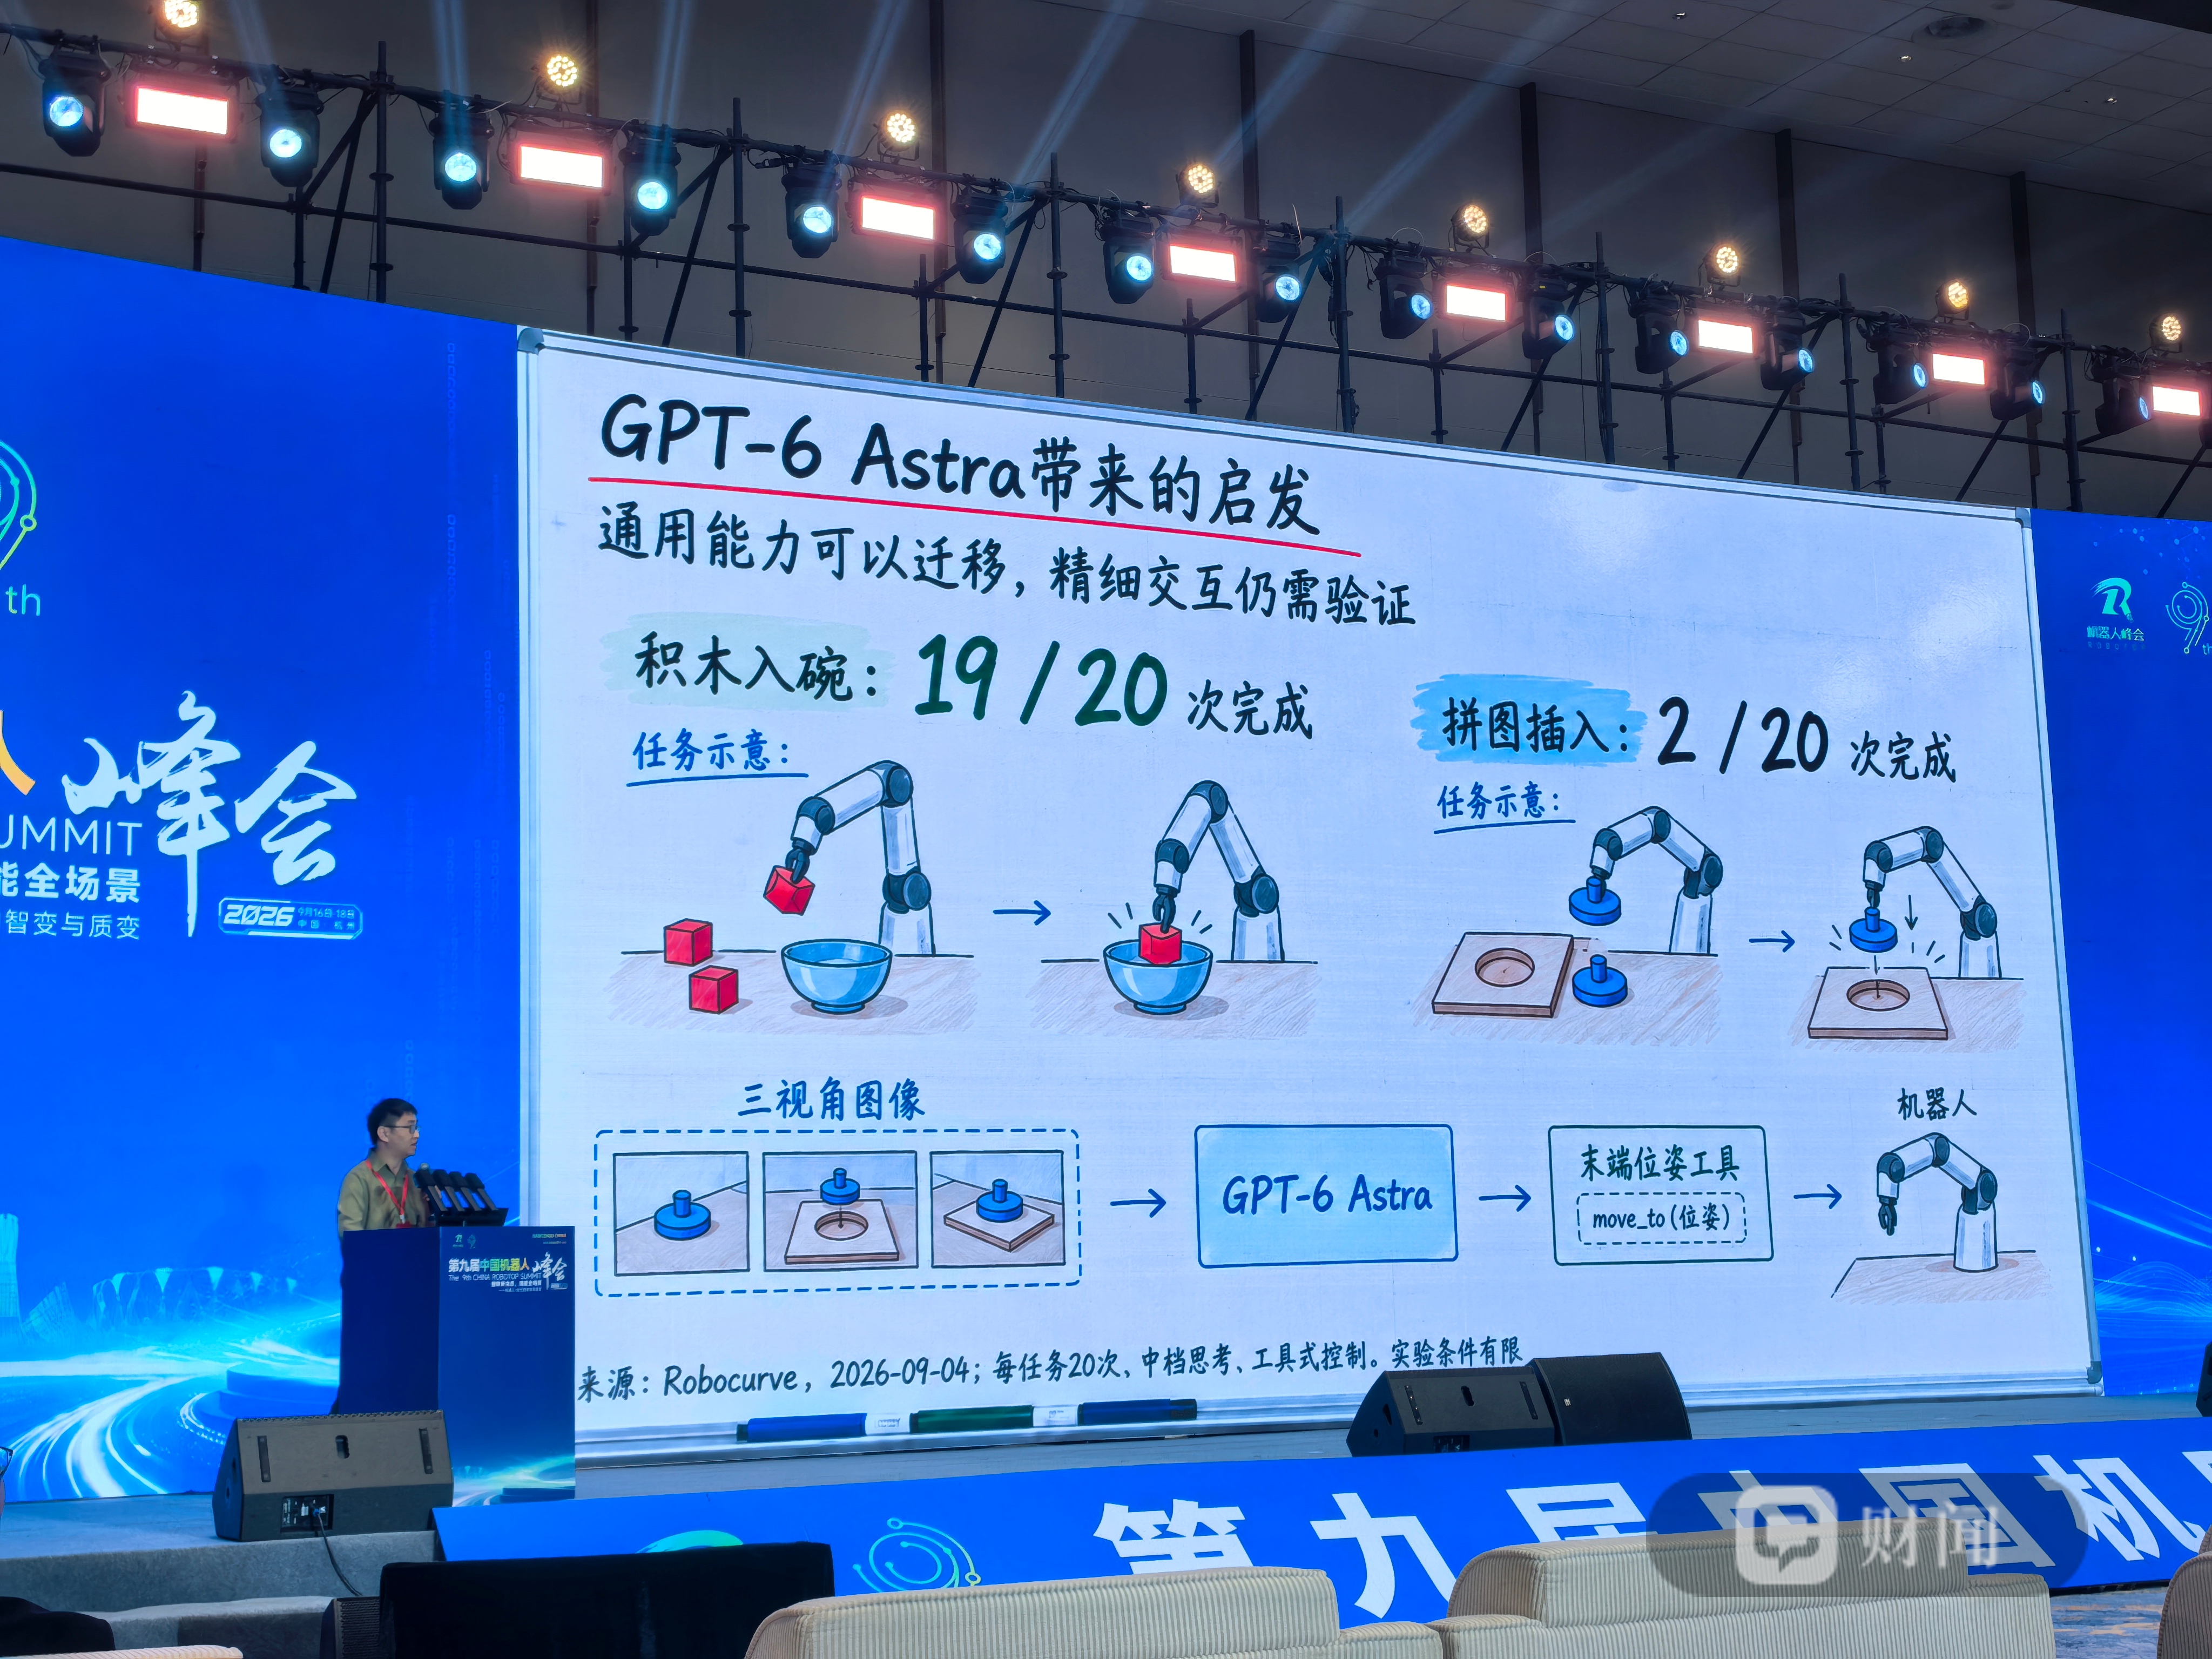
深度机智(北京)科技有限公司创始人陈凯表示,普通头戴相机容易出现同步、抖动和手部离开画面等问题,难以完整记录连续操作。公司因此采用360度全景相机,同时记录人体姿态和周围环境变化。
陈凯披露,深度机智Ego360第一视角数据采集规模已经突破1万小时,首批计划发布100小时,约包含2.2万个片段。采集完成后,公司会对视频进行分段、时间对齐、语义处理和运动估计。首批数据包括任务片段、语义关系、运动轨迹和后续状态四类信息。
拟发布的100小时数据约占公司采集总量的1%。其价值不只在于时长,而在于原始视频经过处理后形成约2.2万个任务片段。按照陈凯介绍的结构,每个片段将连接任务目标、动作过程和后续状态,供模型学习一个动作如何改变周围环境。
数据发布后,外部团队也可以基于同一批样本训练和测试模型,检验第一视角数据在空间理解、动作预测等任务中的作用。
真人第一视角数据能否转化为机器人操作能力,业内仍有争议。由于人机结构不同,人体动作需经转换才能用于机器人控制。陈凯表示,公司下一步将在真实环境中开展闭环验证,并继续扩大数据和模型规模。